スクラムの文献でLLM Wikiを作る - Ingest / Query / Lintの実装と運用
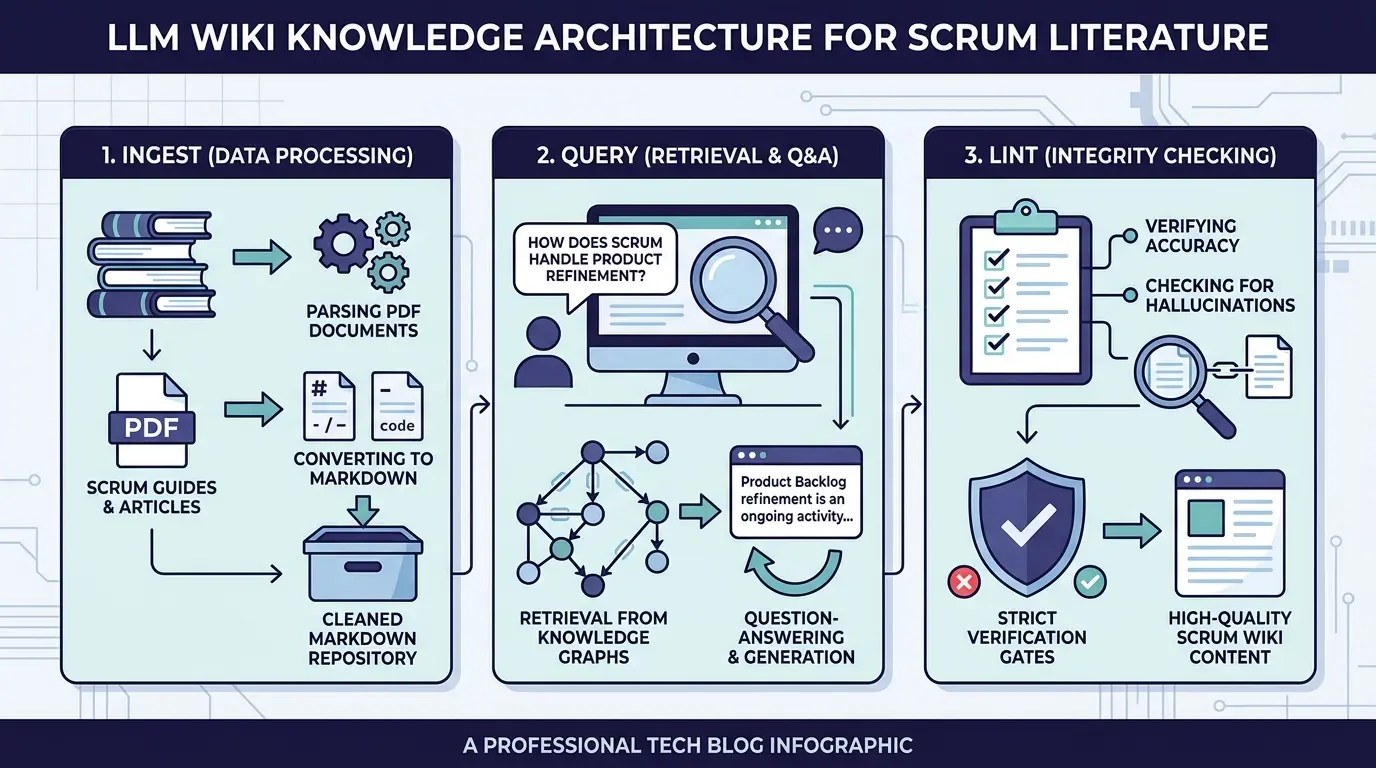
前回の記事からの続きです。この記事ではスクラム文献で作るLLM Wikiの実装の各種操作についてまとめていきます。
LLM Wikiの全体構造
LLM Wiki (Karpathy Gist) で記載されているLLM Wikiの全体構造は以下になります。
| 層 | ディレクトリ | 内容 | 役割・原則 |
|---|---|---|---|
| 生データ層(Raw Sources) | raw/ |
論文、記事、本、画像など、集めてきた元資料 | AIは一切手を加えず「読み取り専用(真実のソース)」として保護。 |
| Wiki層(The Wiki) | wiki/ |
AIが生成した要約、概念ページ、用語集、比較表などのMarkdownファイル群 | 人間は基本的に閲覧するだけで、ページの新規作成・リンク張り・更新作業はすべてAIが担当。 |
| ルール定義層(Schema / 規約ファイル) | ./(ルート直下)(例: CLAUDE.md, AGENTS.md) |
「どのような形式でまとめるか」「何を基準にリンクを貼るか」を定めた設定指示書 | AIを単なる雑談ボットではなく、厳格な「編集担当者」として振る舞わせるための設計図。 |
実際のリポジトリ構成
わたしが作成しているLLM Wikiのリポジトリも、概ね上記と同様の構造で作成しています。
| ディレクトリ / ファイル名 | 説明 |
|---|---|
raw/ |
取り込んできたスクラム文献のPDFをMarkdown化して配置。 |
wiki/ |
Astroプロジェクト。直下にWikiのMarkdownファイルを直接置くのではなく、AstroのコンテンツMarkdownファイルとして配置。 |
CLAUDE.md |
記事生成そのものの指示ではなく、記事生成を行うツールの利用方法や作成方法について記載。 |
実装の操作
機能的には、ingest、query、lintの3つが存在します。
| 操作 | 説明 |
|---|---|
| 取り込み(Ingest) | 新しい記事を投げ込むと、AIが読み込み、関連する複数のWikiページ(1つの資料で10〜15ページに及ぶこともあります)を一括で更新・リンク付けします。 |
| 質問・対話(Query) | Wikiに対して疑問をぶつけます。AIが導き出した質の高い分析や比較表は、チャット履歴で終わらせず、そのまま新しいWikiページとして保存して知識資産にします。 |
| 保守点検(Lint) | 定期的にAIにWiki全体を走査させます。「古い記述と新しい記述で矛盾がないか」「リンクが切れている孤立ページはないか」などを洗い出し、品質を保ちます。 |
個人的なLLM Wikiのコンテキストだと、Astroサイトにしているため、保守点検(Lint)の後に公開(Deploy)も発生します。それぞれの手順を詳細に説明します。
取り込み(Ingest)
PDFをMarkdownに変換する前処理もあるため、処理は4つのステップに分かれます。 大まかには「Step 1: PDF取り込み・Markdown化」「Step 2: 英日翻訳」「Step 3: Wiki更新」「Step 4: ナレッジグラフ生成」という流れです。 前回の記事 スクラムの文献でLLM Wikiを作る - 文献の選定 のとおり、Step 1 の前段階として半自動の文献選定を実施しています。
Step 1: 取得とレイアウト解析(Fetch & Convert)
config.jsonとして登録した取り込み対象文献リストのPDF URLからドキュメントを取得。- ディープラーニングベースのパーサー(
marker-pdf)を用いて、多段組・図表・ヘッダー/フッターを考慮しながら整形されたMarkdownに変換。
Step 2: 文脈を考慮した翻訳(Translate)
- 英語文献を日本語化(
translate_md.py)。 - コストの観点からローカルLLM(Ollama)モデル
translategemma:4bを優先し、エラー時はクラウドAPI(Gemini)へ透過的にフォールバック。
Step 3: オントロジー制約付き知識抽出 & Wiki更新(LLM Wiki Ingest)
- 取り込んだ文献から最新の用語集を生成。
- LLMが文献から概念(Concept)やエンティティ(Entity)を抽出。
- 既存ページが存在する場合は新旧の記述をマージし、出典・引用を紐付け。
Step 4: ナレッジグラフのデータ生成
- 後続処理の質問・対話(Query)で利用するナレッジグラフのデータを生成。
- SQLite に、グラフ構造のデータを保存。
質問・対話(Query)
LLM Wikiに質問をぶつけ、回答を得て、内容が良ければLLM Wikiのページとして保持する操作です。
現在作成しているLLM WikiはAstroベースの静的ページなので、動的にユーザーの質問に答えることはできないため、以下のようなStepで事前生成した回答ページを生成して公開する方式にしました。
Step 0: 質問の定義
Step 1以降はスクリプト化されていますが、質問集(YAMLファイル)の作成は半自動で行っています。 作成したオントロジーの妥当性の検証手法(作成手法)に、コンピテンシー質問(CQ)を作成・評価する METHONTOLOGY という手法があります。 SROもこの手法で作成されており、The-Band-Solution/theband の SRO ドキュメント にコンピテンシー質問の全量が公開されています。この質問を日本語訳したものをベースに利用しています。
ただ、元の質問にはスプリントバックログなど実際のチームメトリクスが必要なものも多く含まれていました。LLM Wikiのデータ単体では答えられないものが多かったため、SROの質問を参考にしながら、LLM Wikiのデータで回答可能な質問へテーラリングして作成しました。
Step 1: 根拠の自動収集(Context Gathering)
質問に対して、取り込み(Ingest)で作成したナレッジグラフデータを使って、根拠となる情報(「公式スクラムガイドの節」「SROオントロジー定義」「関連Wiki記事」)を収集します。
Step 2: ドラフト生成(Draft Generation)
集めた一次情報をもとに、読者が直接元のガイドやWikiに飛べる**「人間可読な引用(Citation)とリンク」付き**のMarkdownドラフトを生成します。
Step 3: 【第1ゲート】形式的・決定論的検証(Formal Verifier)
LLMの出力をそのまま信じず、まずプログラムで厳密なルールチェックを行います。
- スクラムの公式語彙やオントロジー(SRO)の定義から逸脱していないか
- 概念の混同(例: プロダクトオーナーの責務を開発者と取り違えていないか)がないか
- ※違反があれば、指摘プロンプトとともに最大2回まで再生成させる
Step 4: 【第2ゲート】批判的LLM評価(LLM-as-a-Judge)
第1ゲートを通過した回答に対し、別の評価用LLMが「審査員」となって採点します。
- 忠実度(Faithfulness): 提示された一次情報にない勝手な創作(ハルシネーション)をしていないか
- 関連度(Relevance): ユーザーの質問に対して的確に答えているか
- **合格ライン(85点以上)**を満たしたものだけを最終出力として承認する
出来上がる成果物
検証をすべて通過した回答は、サイト上の独立した記事(例: /queries/can-sprint-goal-be-changed)として配置されます。
- 結論(Answer): 回答
- 公式な根拠(Citations): 『スクラムガイド 2020』スプリントゴールの節から抜粋した内容
- オントロジー解説: SROにおける位置づけや制約ルール
- 実践的な注意点・アンチパターン: 現場での適用時のTips
保守点検(Lint)
LLM Wikiを運用する中で、特に重要だと実感したのが「Lintで何を検証するか」という観点と実装でした。
LLMの出力は確率的であるため、ドキュメント上の不整合が不可避的に混入します。また、データパイプラインの実行順序や欠損によるサイレントな破壊も防ぐ必要があります。そのため、大きく分けて**「Wikiコンテンツ(Markdown)の検証」と「派生データ(JSON / SQLite)の完全性検証」**という2つの防壁を設けています。
LLM Wikiを作ってみての感想ですが、Lintがないと、かなりコンテンツが荒れます。
Lintで制約に引っかかった事象から、パイプラインのどこで問題が混入するか調査して、パイプラインを改修するの繰り返しになります。
1. Wikiコンテンツ(Markdown)の検証
LLMが生成・更新したMarkdown群に対し、構文やオントロジーとの整合性を機械的に検証します。
- メタデータ & オントロジー整合性(ERROR)
- フロントマターの適合性:
categoryが正本オントロジー定義のカテゴリ(Scrum Core, Kanban & Flow 等)に完全一致しているかを検査。あわせて参照文献IDが文献定義リスト(Manifest)に実在しているかも確認。 - 文献喪失の防止検知: 既存ページの引用文献リスト(
sources)が、LLMによる全文マージ時に誤って削られていないかをコミット差分レベルで検知。
- フロントマターの適合性:
- ドキュメント構造 & 引用・脚注エビデンス(ERROR / WARN)
- 必須セクション構造: 「概要」「詳細」「出典」などの必須見出しが存在し、見出し階層(H1重複やH2飛ばし等)が正当か。
- 脚注と引用の1対1対応: 本文中の脚注参照記号(
[^sg2020]等)と末尾の定義行が過不足なく対応しているか。引用文が極端に短すぎないか(15文字未満はWARN)。
- 内部リンク整合性と相互参照(ERROR)
- 死リンクの排除: 概念ページやエンティティページへの内部リンク先が実在しているか、非公開(ドラフト)ページへのリンクが混入していないか。
- LLM特有のハルシネーション・文体検査(ERROR / WARN)
- CJK部首・異体字文字化けの検知: 見た目は「は」「の」「進」に似ているがUnicode上で別コードとなる部首文字(康煕部首など)の混入を全行検査。
- 異言語文字の混入検知: 翻訳や要約の過程でLLMが幻覚的に混入させたキリル文字やアラビア文字などの異言語スクリプトを排除。
- 文体・日本語表現チェック: リンター(textlint)を介して「だ・である調(常体)」の統一、二重助詞、長すぎる一文、誇張表現を検出。
2. 派生成果物のデータ完全性ゲート(Data Integrity Gate)
MarkdownからコンパイルされたWeb UI用JSONや検索用SQLiteが、「壊れていないか」「空になっていないか」「大事なデータが勝手に激減(消失)していないか」を検証する仕組みです。 過去に「全消し再構築時に一部の主要ドキュメントが欠損し、データ件数が激減したままコミットされてしまう」というバグを経験して導入しました。
2つの検証アプローチ
主に2観点を確認しています。
- 健全性チェック(Sanity Check):
- ファイルが存在し、JSONやSQLiteとして正常にパースできるか。
- オブジェクトや配列が空(
[],{})になっていないか、ノード数やリンク数が0件でないかを検証。
- 完全性・データ収縮検知(Manifest照合):
- 単なる固定の閾値(例: 「100件以上あればOK」)ではなく、原本となる文献設定リスト(Source Manifest)を直接読み込み。
- 公式一次ガイドとして宣言されている全フレームワーク(Scrum 2020, LeSS, Nexus など)の本文チャンクを集合比較(差分チェック)。1件でも欠損があれば即座に落とす。
パイプラインの各フェーズで実行するので、独立している
このデータ完全性チェックは、機械学習ライブラリやLLMクライアントなどの重い依存を持たせず、標準ライブラリのみで数ミリ秒で完結する独立したLintとして実装しています。開発時のコミット前フック(pre-commit)、PRのCIパイプライン、本番デプロイ直前に最終検証をかけています。
実装上の工夫
実際の問題から、考慮した実装上の工夫を紹介します。
1. データ消失を防ぐEnd-to-End検証
文献を追加取り込みする際、毎回全体を生成し直すとコストがかかりすぎます。そのため llm-wiki の記載どおり文献の差分取り込みを行っていましたが、パイプラインの途中で差分考慮が漏れて「他の記事が消える」という事故が発生しました。 そこで、文献取り込み(Ingest)で管理している対象文献リストをもとに、最終成果物へ取り込み対象の文献がすべて含まれているかを確認するLintを追加しました。
2. LLMの過剰関連付けを防ぐ
概念、用語のコンテンツで、関連する既存ページと引用文献の紐付けを作っていますが、LLMが「広く解釈すれば関係ある」と偽陽性を起こし、無関係な既存ページの引用文献を再生成していました。
原文中に該当用語の記述があるかをコード側で独立検証(エビデンス検証)し、Gitコミット履歴と比較して引用文献情報が1件でも減っていればCIを止めるようにしました。
3. 文字化け汚染を防ぐ「CJK部首文字の正規化 & 全走査Lint」
英語論文は「PDF → Markdown(英語) → LLMで日本語Markdown」という形で取り込みます。 しかし、LLMが稀に通常の漢字・ひらがなではなく、見た目が同一で文字コードが異なる「部首用の特殊文字(CJK部首補助文字)」を出力し、検索ヒット不能になる問題が発生しました。 対策として、特殊な部首文字を通常文字へ置換する正規化処理と、文書全行を生テキスト走査して混入を未然にブロックするリンターを実装しています。
4. textlint × AI修正のモグラ叩き
概念・用語の文章は、textlint のプリセット textlint-rule-preset-ai-writing でルール違反を検出しています。 当初は「エラーのAI自動修正」と「textlintのチェック」をループで回していました。しかし、別のルール違反を生んだり文意が歪んだりして無限ループに陥ってしまいました。 途中から導入したのも一因と考えられますが、完璧な自動修正は諦めました。textlintの警告はERRORではなくWARNに留め、「既存件数を超えたらCI停止、同数以下なら許容」として悪化のみを阻止する形式にしています。
以上で、Ingest | Query | Lint の説明は終わりです。