AI-SDLC Maturity Model で開発プロセスアセスメントを試した
スクフェス新潟 2026 の松岡さんのセッション動画「AI駆動開発で生産性を追いかけたら、行き着いたのは品質とシフトレフトだった」を視聴し、AI-SDLC Maturity Model を知りました。 AI活用を前提とした開発プロセスの現在地を知り、「これから何を変えていくのか?」を見える化するのに良さそうだったため、チームメンバーと隔週で実施しているふりかえりの一環で試してみました。 個人的に当初想定した通り効果がありそうなので、今後実施する時のために、事前準備の仕方やアセスメントの進め方などをまとめておきます。
AI-SDLC Maturity Modelについての説明
AI-SDLC Maturity Modelとは?
セッション動画で紹介されているのは、以下の記事になります。
以下、上記の記事をGemini Notebook にまとめてもらった概要です。
ソフトウェア開発ライフサイクル(SDLC)において、単なる個人のAIツール利用(コード補完など)から、**組織の開発プロセスをAI-Native、Agentic SDLCへ進展させるための評価・診断フレームワークです。単に「AIツールを何個導入したか」ではなく、開発プロセス、ガバナンス、品質検証、およびCI/CDパイプラインにAIがどのように統合されているかを多角的に測定します。
5段階の成熟度レベル
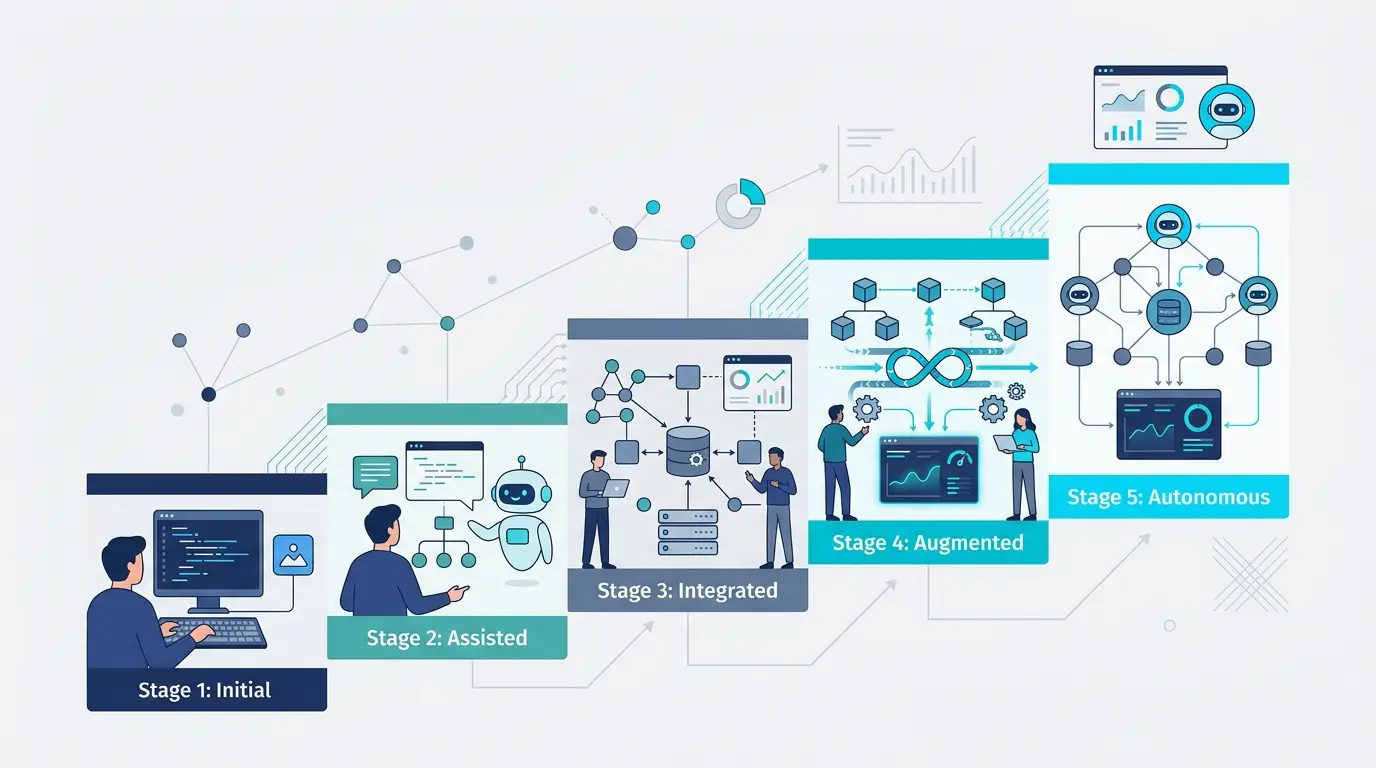
各開発プロセスにおけるAIの活用状況を以下の5段階の成熟度レベルで評価する形になります。 ELEKSの記事でも触れられている通り、必ずしもLevel 5を目指さなければならないわけではありません。自社の業務ドメインやリスク許容度に合わせて(Level 4やLevel 5では厳格な自動品質ゲートやリスク許容の判断が求められるため)適切な目標レベルを設定することが重要です。
| レベル | 名称 | AIの関与・役割 | 人間の役割・運用要件 |
|---|---|---|---|
| Level 1 | Traditional SDLC(伝統的開発) | 不使用手動記述や基本的なIDE機能のみ。 | 品質・文脈把握ともに個人のスキルに完全依存。 |
| Level 2 | AI-supported SDLC(受動的支援型) | 定型作業のパッシブ補完単一ファイルのコード自動補完やログ要約などを実施。 | 人間が全権を掌握し、AIは補助輪として活用。 |
| Level 3 | AI-assisted SDLC(能動的支援型) | 能動的な提案複数ファイルを認識し、大きなコードブロックやモジュール改善案を能動提示。 | 出力の確認・修正など、人間の「検証負担(検証税)」が増加し始める。 |
| Level 4 | AI-native SDLC(協調・エージェント型) | 自律的なタスク遂行仕様書から機能実装、自動テスト、ドキュメント更新、PR作成まで自律実行。 | 成果物をレビュー・統合。CI/CD上の強固な「自動品質ゲート」配備が前提。 |
| Level 5 | AI-autonomous SDLC(完全自律型) | 自律統括要件分析からコード実装、テスト、デプロイ、本番の障害自己修復までエンドツーエンドで統括。 | 人間は例外処理(エスカレーション対応)と戦略的判断のみを担当。 |
評価対象のプロセスの切り口について
AI-SDLC Maturity Model: Traditional to Autonomous Developmentからは、2つの切り口が読み取れました。1つは開発プロセスで、もう1つは「何を人間が確認して、何をAIに任せるか?」という組織ガバナンスの切り口です。
- 開発プロセス工程での切り口 各開発工程を軸に評価する形です。ざっくり以下のようなプロセスの記載がありました。
| 開発工程 | 主なAI活用内容・評価の着眼点 |
|---|---|
| 要件定義・計画(PRD / Requirements) | ステークホルダーのインプットからの要件ドラフト作成、ユーザーストーリーの自動生成、要件の矛盾や抜け漏れの検知。 |
| 設計・アーキテクチャ(Architecture) | サービス間連携の認識、クロスモジュールでの改善提案、アーキテクチャ案の策定や継続的最適化。 |
| 実装・コーディング(Implementation) | 単純な補完・スニペット生成から、複数ファイルにまたがるコード生成、仕様書からのフル機能実装、リファクタリング。 |
| 品質保証・テスト(Testing & QA) | ユニット/統合テストの自動生成、カバレッジの最適化、テストの自動実行とコード追従。 |
| コードレビュー・セキュリティ(Code Review & Security) | コードスメルの自動検出、脆弱性スキャン、プルリクエストの自動差分チェックと承認判断。 |
| ドキュメンテーション(Documentation) | 会議の文字起こしによる決定事項記録、技術仕様書やREADME、変更履歴(チェンジログ)やリリースノートの自動更新。 |
| 運用・保守(Maintenance & Incident Resolution) | 既知の障害・バグの自律修正、新規障害のエスカレーション。 |
- 組織ガバナンスの切り口
組織ガバナンスとしての切り口は以下の通りです。 Human-in-the-loopのLevelが上がるほど、「人間がどこまでレビューするのか?」が論点になります。このレビューゲートを決定する上で、承認フレームワークや監査ログといった観点を踏まえて議論していく必要があります。
| ガバナンス観点 | 英語表記 | 主な評価の着眼点・要件 |
|---|---|---|
| 人間の関与度と役割 | Human-in-the-loop | AIが「受動的な補完(Level 2)」から「能動的な支援(Level 3)」、「チームメンバーのような協調(Level 4)」、そして「主たる実装者(Level 5)」へと進む中で、人間の役割が「作業の実行」から「監督・戦略的判断・レビュー」へどうシフトしているか。 |
| 変更の分類と承認フレームワーク | Change Classification | フォーマットやテスト追加などの定型作業(自動承認)、リファクタリング(AI承認・ログ記録)、新規ビジネスロジック(人間レビュー)、セキュリティやインフラ変更(人間による必須レビュー)といった、リスクに応じた階層的な承認プロセスが整っているか。 |
| 監査ログと説明責任 | Audit Logging & Accountability | AIの判断理由、確信度スコア、通知ステータスなどのログが追跡可能になっているか。 |
| コード品質・デリバリー安定性の指標 | Quality & Delivery Metrics | 単なる作業スピードの感覚(Perception gap)にとどまらず、重複コードの増加率、リファクタリング比率、脆弱性の混入率、デリバリーの安定性(DORAメトリクス)などを客観的に測定できているか。 |
- その他のAI-SDLCの評価モデル AI成熟度モデルについて、その他参考になりそうなモデルには以下がありました。 レベル分けという意味では大きな差分はありませんが、評価の切り口がより詳細に定義されているものや、エンジニアの熟達度を評価軸に追加しているものなどがあります。 組織の状況やチームに合わせて適宜使い分けたり、アイディアを参考にしながら自分たち向けにアレンジするのが良さそうです。
- Gartner AI Maturity Model and AI Roadmap Toolkit | Gartner
- OWASP/www-project-ai-maturity-assessment: OWASP Foundation web repository
- AI-Maturity-Model/methodology.md at main · Gigacore/AI-Maturity-Model
- DEFRA/ai-sdlc-maturity-assessment
- Responsible AI Maturity Model - Microsoft Research
AI-SDLC Maturity Modelの評価表
記事には評価表のテンプレートそのものはないため、上記2つの切り口と評価軸を組み合わせて、以下のようなテンプレートを作成しました。
| 開発工程(タスク) | 現状レベル(Lv 1-5) | 目標レベル(Lv 1-5) | 人間の役割(Human-in-the-loop) | 承認・品質ゲート(承認フロー・自動検証) | 監査・メトリクス(説明責任・品質指標) | ネクストアクション・課題 |
|---|---|---|---|---|---|---|
| 要件定義・計画(PRD / ストーリー作成) | Lv 2 | Lv 3 | [例] 人間が壁打ち・要件の最終精査 | [例] POによる手動承認 | [例] 抜け漏れ指摘数、見積もり乖離 | 生成されたストーリーの受け入れ基準の標準化 |
| 設計・アーキテクチャ(方式設計 / ADR) | Lv 1 | Lv 2 | [例] 人間が主導、AIは壁打ち・構成レビュー | [例] アーキテクチャレビュー(人間) | [例] ADR(決定ログ)へのAI活用履歴記録 | ADRテンプレートへのAIプロンプト組み込み |
| 実装・コーディング(機能開発 / リファクタリング) | Lv 3 | Lv 4 | [例] AIが実装・人間がレビューと統合 | [例] PR作成時のCI自動パス+ピアレビュー | [例] テストカバレッジ、コード重複率 | 複数ファイル変更時のコンテキスト共有ルールの確立 |
| 品質保証・テスト(単体・統合・E2E) | Lv 2 | Lv 4 | [例] テストケース作成の指示とカバレッジ確認 | [例] CIでの自動実行・カバレッジゲート | [例] C0/C1カバレッジ、手戻りバグ数 | 既存テストのないレガシーコードへの自動テスト拡充 |
| コードレビュー・セキュリティ(静的解析 / PRレビュー) | Lv 2 | Lv 3 | [例] AI指摘の採否判断、文脈レビュー | [例] リンター・SASTの自動パス | [例] 指摘件数、脆弱性検知率 | AIレビューbotの導入とノイズ削減のチューニング |
| ドキュメンテーション(README / リリースノート) | Lv 2 | Lv 4 | [例] 生成内容の目視チェックのみ | [例] PRマージ時のチェンジログ自動生成 | [例] ドキュメント陳腐化の検知件数 | リリースノート自動生成スクリプトのCI組み込み |
| 運用・保守(エラー調査 / ログ分析 / 障害対応) | Lv 1 | Lv 2 | [例] 人間主導、AIにログを食わせて原因推論 | [例] 本番環境への直接修正は人間承認必須 | [例] MTTR(平均修復時間)、エラーログ解析率 | エラー監視通知へのAI一次解析結果の自動付与 |
アセスメントを実際にやってみた時の記録とふりかえり
以下、実際にアセスメントを実施した時の記録とふりかえりです。
事前準備
Notion AIに AI-SDLC Maturity Model: Traditional to Autonomous Development を読み込ませてテンプレートDBを作成してもらいました。 今回はガバナンス観点を含めず、工程ごとの成熟度評価表を作成して実施しています。事前準備にかけた時間は1時間程度でした。
アセスメント
週次のふりかえりの一環として実施しました。チームメンバーと対話しながら、工程ごとの入力と評価を埋めていく形で進めました。 入力基準を会話しながら成熟度レベルの基準をすり合わせ、数値や具体的なコメントを入力していきました。 2名で実施したところ、約1時間ですり合わせが完了しました。 その後のTryまで議論する時間はありませんでした(無理に進めればできた可能性もあります)。それでも、成熟度レベルの目線合わせができた状態で完了としました。
ふりかえり
「+」「Δ」(プラス&デルタ)形式で記載します。
-
「+」AIに評価表をインプットにして、現在の開発工程の成熟度を評価させると効率が良い Gitリポジトリと評価表をインプットにしてAIに成熟度を評価させると、非常に効率が良いと感じました。 評価表を作成したうえでNotion AIにリポジトリを読み込ませ、出力された数値を人間が修正しながら入力していく流れで進めました。 リポジトリからプロセスの情報が読み取れなければレベルが下がりますし、情報が充足していればレベルが上がる形になります。
-
「+」評価そのものよりも、なぜその評価なのか? の文脈を形成することが大事 評価を入力する際、「なぜその評価なのか?」をメンバーと会話しながら進めることが重要だと感じました。 そのため、あえて事前入力はせず、AIを使うにしてもその工程の評価観点をメンバーと話し合って決めます。評価についても対話を通じて文脈を共有しながら合意に至るのが効果的でした。会話の中で浮き彫りになる認識のズレこそが、今後のアクションアイテムにつながるはずです。
-
[Δ]プロセスは、開発文脈に合わせて、調整していく必要がある 「要件定義・計画」のような大枠のプロセス名だけでは、抽象度が高すぎて具体的なアクションアイテムが出にくいと感じました。 全体像をつかむための大まかな評価であれば大枠で十分ですが、詳細タスクまでブレイクダウンして対話することで、具体的なアクションアイテムが見えてきそうです。
-
[Δ]Gitリポジトリにログが残らない開発プロセスの評価 データや証跡が存在すれば、LLMが評価表に従ってある程度自律的に評価できます。しかし、IssueやPRを含めてGitリポジトリにログが残らない開発プロセスだと、評価自体が難しいと感じました。 評価できないということは成熟度も下がるはずであり、そこからどのように成熟度を引き上げるか? が重要な課題になります。 要件定義プロセスであればNotionやJiraで管理しているケースも多く、アセスメント情報もGitリポジトリ以外のツールから取得することになります。そうした外部ツール側にAIが解釈可能な構造化データを残しておくと、評価が格段にしやすくなります。このあたりは、CMMIやITILのようなプロセス改善のベースライン作りが求められると感じました。 記録自体もAIで残しやすくなっているため、記録されていないのであれば、まず記録すること自体を簡略化・自動化していく形になりそうです。
-
[+]レトロスペクティブ、ふりかえりを開発プロセスとして行追加すると良さそう AIエージェント駆動での開発スタイルでは、ふりかえりが以下のような多層的な観点に分かれていくと感じています。このあたりをプロセスとして認識し、評価項目に追加すると良さそうです。
- AIと開発者のセッション完了時のふりかえり。
例:セッションでの問題点や、
CLAUDE.mdに追記すべきルール、Skill化すべき作業などを記録する。 - AIと開発者との定期的なふりかえり。
例:[1]の活動の記録から、実際に個人の
CLAUDE.mdを修正したり、Skillsを作成・変更・削除する。 - チームでのふりかえり。 例:[2]の活動から、チーム全体のルールにすべきことを議論して決定する。 例:チーム全体のAI活用プラクティスやガードレールのアップデート。
- AIと開発者のセッション完了時のふりかえり。
例:セッションでの問題点や、
[1]や[2]は従来であれば個人のふりかえりに包含され、チームで深く言及することは多くありませんでした。 しかし、AIによって個人の生産性が飛躍した現在では、[1]や[2]の実践度合いによってチーム全体の増幅率が大きく変わってくると実感しています。
以上です。継続的に実施していくなら、アセスメントを自動評価するAIスキルを作るのも良さそうです。 試しに自分のプロジェクトで作成してみたところ、メトリクスの収集方法はどうしてもリポジトリ固有の設定に依存してしまい、そのままでは汎用的に公開しづらいと感じました。 今後はリポジトリ固有の表現を抽象化し、汎用的なスキルとして整えられるかを試してみるつもりです。